現場の課題:積み重なる画像加工作業を完全自動化できるか
「毎日、新しい商品が届くたびに発生する画像の切り抜きやサイズ調整に追われている」「少しでも早くECサイトにアップして販売を開始したいのに、手作業での画像加工に時間を奪われている」
ECサイトの運用現場で、こうした悩みを抱えていませんか?
こんにちは。株式会社久(Q Inc.)でデータサイエンティストを務めるRINです。
前職ではECモールの運営や在庫管理などの実務を担当しており、この単純作業の辛さは私自身も痛いほど経験してきました。
商品の背景を綺麗に切り抜き、不要な余白を削り、指定された規定サイズ(例えば2000×2000ピクセルなど)の白背景の中央に配置し直す。さらに、商品が自然に見えるように影を追加する。
1枚5分程の作業でも、数百枚となれば運用担当者のリソースを著しく圧迫し、本来注力すべき「売上をつくるコア業務」の時間を奪ってしまいます。
この属人化と見えないコストを根本から解決するため、「担当者がクラウドストレージ(S3)のフォルダに対象画像と指示書を置くだけ」で、自動的にAIがすべての加工を済ませてくれるシステムの構築プロジェクトがスタートしました。
本コラムでは、データサイエンティストである私が実際に開発現場で直面した技術的な「壁」と、それをどう乗り越えて完全自動化を実現したのか、リアルな開発録をお届けします。
インフラ選定:なぜAWS LambdaとS3の構成を選んだのか
自動画像処理システムを構築するにあたり、最初に直面したのがインフラの選定です。
自社内に専用の画像処理サーバーを構築し、常時稼働させておくアプローチもありますが、これには保守管理のコストや、サーバーリソースの維持費が継続的に発生します。画像の加工処理は、新しい商品の登録時や、シーズンごとのカタログ更新時など、特定のタイミングに負荷が集中する傾向があります。
そこで私たちは、サーバーレスアーキテクチャである「AWS Lambda」と、オブジェクトストレージである「Amazon S3」を組み合わせた構成を採用しました。 この構成の最大の利点は、「処理が実行された時間だけ」課金されるという点です。
さらに、S3の特定のフォルダ(今回はinputフォルダ)にファイルがアップロードされたことをトリガーとして、自動的にLambdaのプログラムを起動させることができます。
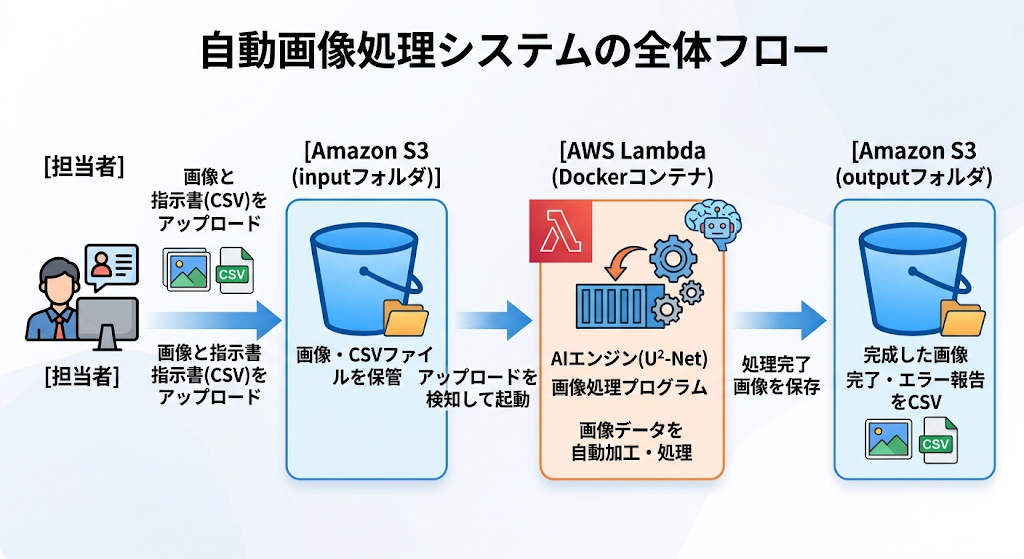
システム全体のフローは以下のように設計しました。
- 入力: 担当者がS3の
input/{バッチ名}/フォルダに、処理対象の画像群と、指示書となるinstruction.csvをアップロードする。 - 検知と起動: S3のイベント通知機能がアップロードを検知し(サフィックス指定) 、AWS Lambdaを起動する。
※画像1枚ごとのアップロードでLambdaを起動させないことで、同時実行数の枯渇(スロットリング)を防ぐ設計にしています。 - 制御と処理: Lambda上に配置されたプログラムがCSVを読み取り、指示に従ってAIエンジンに画像データを渡し、切り抜き、補正、リサイズを実行する。
- 出力と報告: 処理が完了した画像をS3の
output/{バッチ名}/フォルダに保存し、全件成功時は _END ファイルを、エラー発生時はerror_report.csvを出力する。
このアーキテクチャにより、インフラの保守管理から解放され、スケーラビリティが高く、運用コストを最適化した自動化システムの基盤が描けました。しかし、机上の設計図通りには進まないのが現場の開発です。
自前AI実装の壁:重すぎるAIモデルとDockerコンテナの導入
AWS Lambda上で画像処理を行うプログラムを作成し始めると、最初の技術的な壁にぶつかりました。「AIモデルの容量問題」です。
本システムでは、背景切り抜きの精度を最高水準に保つため、高精度なAIモデルである『U²-Net』(rembgライブラリ)を採用しています。このAIモデルは、髪の毛の隙間や透明な素材のエッジなど、複雑な境界線を非常に高い精度で認識し、切り抜く能力を持っています。
しかし、その分モデルのデータサイズが大きく、加えて画像を処理するためのPillowなどの各種Pythonライブラリを含めると、全体のファイルサイズは数百メガバイトに達します。
AWS Lambdaには、アップロードできるデプロイパッケージのサイズに制限があります(ZIP形式で解凍後250MBまで)。U²-Netのモデルファイルと必要なライブラリ群をそのままZIP化してアップロードしようとすると、この容量制限に引っかかってしまい、そもそもプログラムを配置することができませんでした。
この容量制限を突破するために導入したのが「コンテナイメージサポート (Container Image Support) 」技術です。 AWS Lambdaは、ZIPファイルだけでなく、コンテナイメージをデプロイする機能(最大10GBまで)をサポートしています。
私たちは、必要なAIモデル(u2net.onnx)、画像処理ライブラリ、そして自作のプログラム(実行用の lambda_function.py と、加工用の core_engine.py)をすべて1つのDockerコンテナという「箱」の中に詰め込みました。
作成したコンテナイメージは、AWSのコンテナレジストリサービスであるECR(Elastic Container Registry)に登録し、そこからLambda関数として呼び出す構成にしました。
具体的な手順としては、ローカル環境で以下のコマンドを実行し、ビルドとアップロードを行います。
Bash
docker build --no-cache --provenance=false --platform linux/amd64 -t rembg-lambda .

docker tag rembg-lambda:latest {AWS_ACCOUNT_ID}.dkr.ecr.ap-northeast-1.amazonaws.com/rembg-lambda-repo:latest

docker push {AWS_ACCOUNT_ID}.dkr.ecr.ap-northeast-1.amazonaws.com/rembg-lambda-repo:latest
これにより、自前の高度なAIエンジンをAWS Lambda上で稼働させる環境が整いました。インフラの問題はクリアできたと安堵したのも束の間、実運用に向けたテストを実行した際に、次なる大きな壁が立ちはだかりました。
現場のリアルな壁:無情なタイムアウトとLambda「10秒ルール」
コンテナイメージのデプロイが完了し、S3にテスト画像とCSVをアップロードして処理を開始させました。しかし、出力フォルダには画像が生成されず、Amazon CloudWatchのログには無情にもタイムアウトによるエラーが並んでいました。
AWS Lambdaには、関数の実行が許可される最大時間(タイムアウト時間)が設定されています。デフォルトの設定では数秒となっており、重い画像処理を行うには短すぎます。そこでタイムアウト設定を最大値(15分)に引き延ばして再度テストを行いましたが、それでも最初の1枚目の処理を開始する直前で、謎の強制終了が発生してしまうのです。
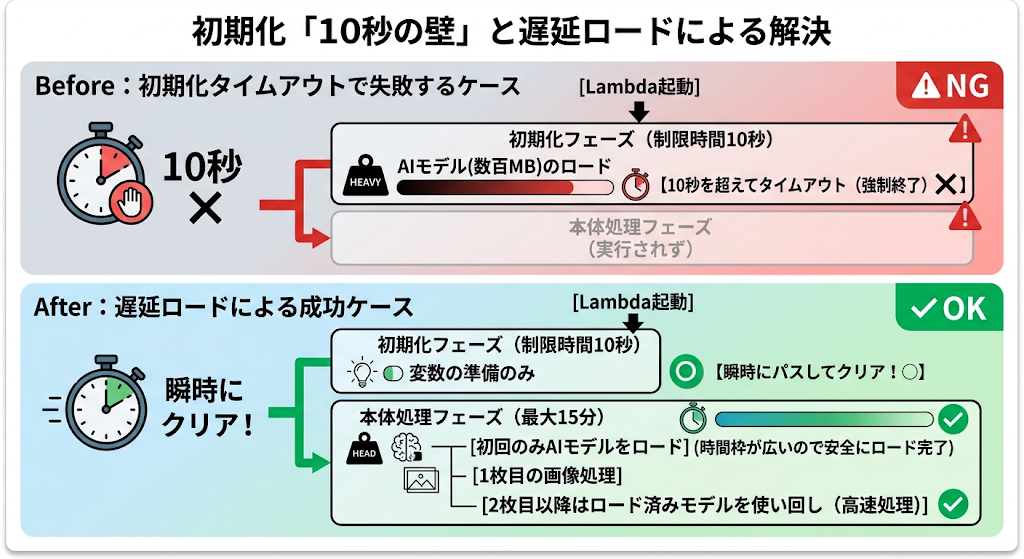
ログを詳細に追跡して判明したのは、Lambdaの初期化プロセスにおける「10秒の壁」でした。 Lambdaは、関数が初めて呼び出されたとき(コールドスタート時)に、コンテナをロードし、初期化コードを実行します。この初期化フェーズには10秒という短い制限時間が設けられています。
私たちの初期のコードでは、画像1枚を処理する関数が呼び出されるたびに、U²-NetのAIモデルをメモリ上にロードする処理を行っていました。
数百メガバイトのAIモデルをディスクから読み込み、推論可能な状態に準備するまでのプロセスに10秒以上の時間がかかっており、関数が本体の処理に入る前に「初期化タイムアウト」としてシステム側から強制終了させられていたのです。
ローカルの開発PCであれば数秒で終わる処理も、クラウド上の制約されたリソース下では想定外の時間を要します。この「環境の違いによる制約」こそが、サーバーレスアーキテクチャでAIを動かす際の最大の難所でした。
解決策:処理のタイミングをずらし、メモリを最大限に活用する
このタイムアウト問題を突破し、安定稼働を実現するために、私たちはアーキテクチャと設定を大きく見直しました。
1. AIモデルの遅延ロード(Lazy Loading)による10秒ルールの回避 最大のボトルネックであった「AIモデルのロード時間」のタイミングを変更しました。 グローバルスコープでのロードをやめ、「メインの関数が呼び出された時(Invokeフェーズ)に、初回だけAIモデルをロードする」手法(遅延ロード)を採用したのです。
Python
from rembg import remove, new_session

# グローバルスコープでは変数の準備のみ(10秒制約を瞬時にパスする)
session = None

def lambda_handler(event, context):
    global session
    # 初回の画像処理時のみAIモデルをロード(最大15分の枠内で行う)
    if session is None:
        session = new_session("u2net")
Lambdaは連続して呼び出される際、同じコンテナ環境を再利用する(ウォームスタート)性質があります。この設計により、1枚目の処理でモデルを読み込んだ後は、2枚目以降は重いロード処理がスキップされ、ロード済みの session を使い回すことができるようになりました。
2. メモリ設定の最適化
AIによる背景切り抜き処理(特にアルファ・マッティングを用いたエッジの微細な計算)は、CPUとメモリを大量に消費します。Lambdaの処理能力(割り当てられるCPUパワー)は、設定したメモリサイズに比例します。
当初はコストを抑えるために数GB程度のメモリ設定でテストを行っていましたが、処理スピードが遅く、大規模な画像のバッチ処理には耐えられませんでした。
AIによる背景切り抜き処理(特にアルファ・マッティングを用いたエッジの微細な計算)は、CPUとメモリを大量に消費します。Lambdaの処理能力(割り当てられるCPUパワー)は、設定したメモリサイズに比例して向上します。
当初はコストを抑えるために数GB程度のメモリ設定でテストを行っていましたが、処理スピードが遅く、実用に耐えませんでした。そこで今回はPoC(概念実証)フェーズにおける「開発スピードと動作確認」を最優先し、一時的な暫定処置としてメモリ上限を最大値に近い「10000 MB(10GB)」へと大胆に引き上げました。
この最適化によりAIの高負荷計算が安定し、1枚あたりの処理スピードが劇的に向上しました。(※本格的な商用展開の際には、「AWS Lambda Power Tuning」等のツールを用いてコストとパフォーマンスの最適な分岐点をベンチマーク測定する予定です)
3. 一時メモリ制限の回避
もう一つの隠れた壁として、Dockerコンテナ上でAIライブラリ(Numbaなど)を動かす際の一時メモリの制約がありました。AWSのセキュリティ仕様上、コンテナ内の共有メモリ領域(/dev/shm)のサイズが制限されているため、処理中にエラーが発生することがありました。
この問題に対しては、環境変数を設定し、キャッシュや一時ファイルの保存先をLambdaで許可されている一時ディレクトリ(/tmp)に逃がすことで回避しました。
これらの工夫と調整を積み重ねることで、ようやく「S3イベント検知 → Dockerコンテナ起動 → AIモデルのロード → 画像処理 → S3への保存」というシステム全体の血流が、タイムアウトすることなく最後まで開通しました。
次のステップへ:インフラ完成、しかし次なるエラーの影
こうしてインフラと基本処理が完成し、CSVの指示に基づき「切り抜きなし(余白調整とリサイズのみ)」の処理は完璧に動作するようになりました。
処理区分を「2(切り抜きなし)」とし、サイズ比率(size_ratio)を90と指定すれば、元画像が自動で縮小され、2000×2000ピクセルの白背景キャンバスの中央に綺麗に配置されて出力されます。
システム構築の第一段階は成功です。しかし、本命であるAIを使った「標準切り抜き(処理区分:1)」モードのテストを実行した際、次なるエラーメッセージがログに記録されていました。
TypeError: a bytes-like object is required, not 'Image'
PythonのPillowライブラリで読み込んだ画像データを、そのままAIエンジン(rembg)に渡そうとしたことで発生した、データの「型」に関するエラーです。
次回(第2回)は、このエラーの原因である「プログラムからAIへの画像データの渡し方」と、画質を一切劣化させずにシステムとAIを連携させるプログラミングの工夫について、コードレベルで詳細に解説します。
■ECサイト運用の自動化・業務効率化のご相談はこちら
〈筆者プロフィール〉
データサイエンティスト RIN
前職では、出版業界にてECモールの運営や在庫管理などの実務を担当。現在は株式会社久にて、データサイエンティストとして購買データや会員データの加工、分析、モデル構築などに携わる。 本コラムでは、EC現場での実体験とデータサイエンスの知見を掛け合わせ、データ連携や前処理の時短テクニック、AIを活用した業務効率化のノウハウをわかりやすく解説します。